생성형 AI의 개인정보 문제는 “이름을 지웠는가” 하나로 끝나지 않는다. 입력 데이터의 민감도, 사용하는 제품 유형, 계정 소유자, 보관 기간, 모델 개선 사용 여부, 연결 앱, 사람이 결과를 다시 공유하는 과정이 하나의 데이터 경로를 만든다. 교회는 기도제목, 상담 기록, 아동 정보, 헌금·인사 자료처럼 관계와 맥락만으로도 개인을 알아볼 수 있는 정보를 다루기 때문에 이 경로를 먼저 이해해야 한다.
같은 서비스 이름도 데이터 조건은 다를 수 있다
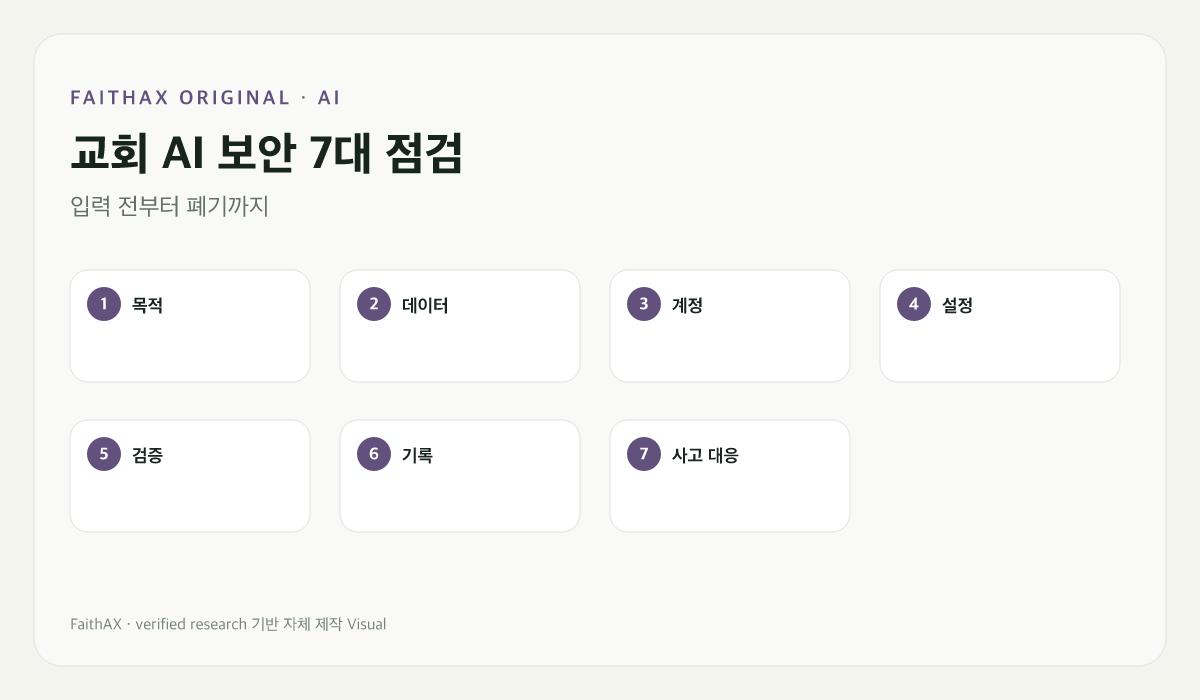
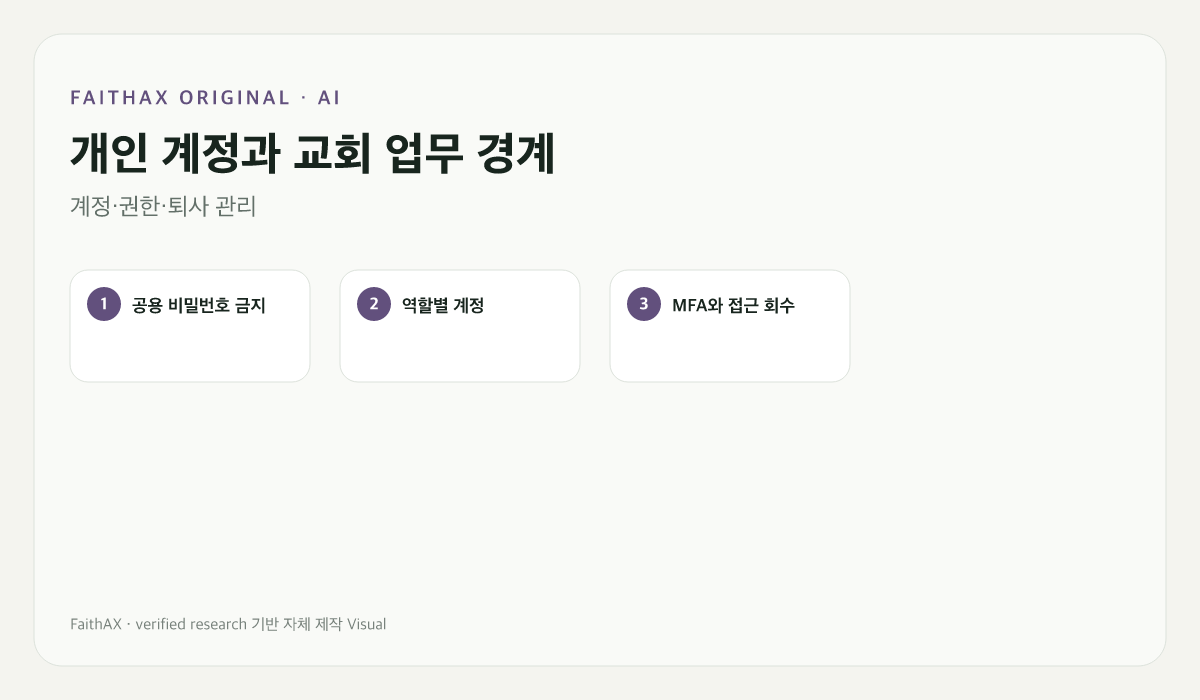
개인용 계정, 조직용 업무 상품, API는 서로 다른 설정과 약관을 가질 수 있다. 예를 들어 OpenAI는 비즈니스 상품과 API 입력·출력을 기본적으로 모델 학습에 사용하지 않는다고 설명하지만, 개인용 서비스는 사용자의 데이터 제어 설정에 따라 조건이 달라질 수 있다. “유료니까 안전하다”가 아니라 정확한 상품과 관리자 설정을 확인해야 한다.
데이터 경로의 여섯 지점
입력
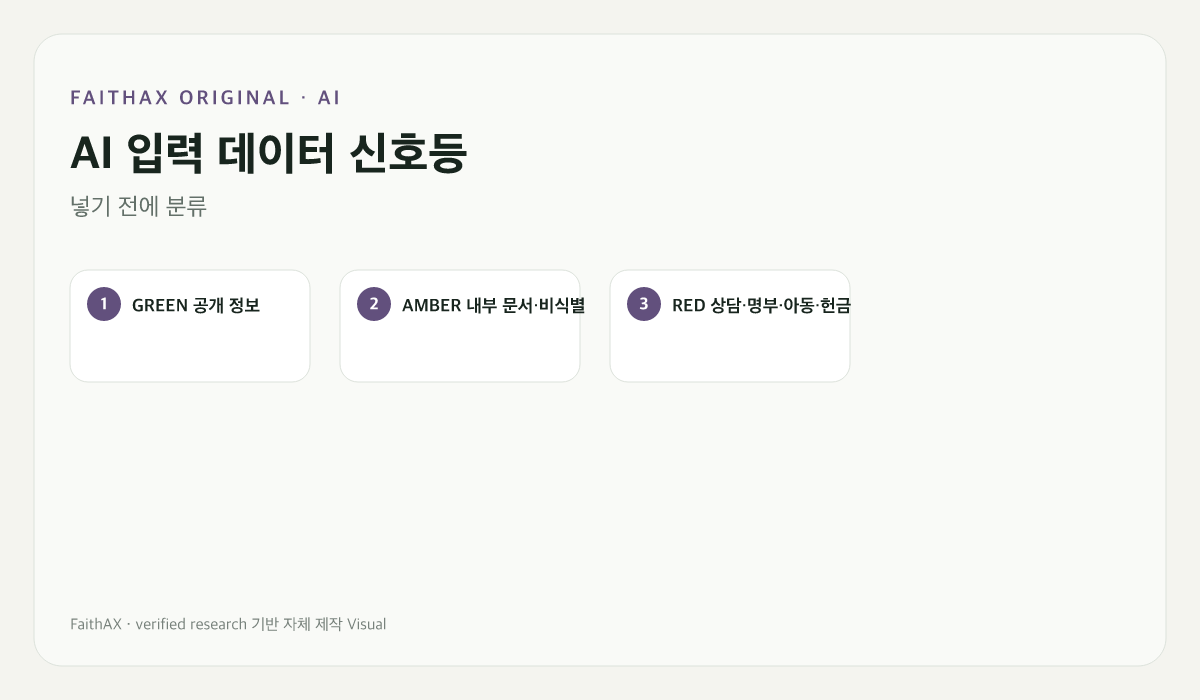
이름을 삭제해도 직분, 사건 날짜, 가족관계, 소그룹 같은 조합으로 개인이 식별될 수 있다. 공개 정보, 내부 업무 정보, 입력 금지 정보로 구분하고 상담·기도·아동·재정 자료는 기본적으로 입력하지 않는다.
전송과 저장
암호화 설명은 중요하지만 보관 기간과 삭제 방식도 별도 항목이다. 공급자의 데이터 처리 문서에서 채팅 기록, 파일, 로그, 삭제 요청의 범위를 확인한다.
학습과 개선
모델 학습 사용 여부는 제품과 설정에 따라 다르다. 관리자 정책과 실제 사용자 화면이 일치하는지 확인하고, 개인 계정에 교회 자료가 흩어지지 않게 한다.
연결 기능
드라이브, 메일, 문서 검색 같은 연결 앱은 AI가 접근할 수 있는 범위를 넓힌다. 연결 권한이 읽기 전용인지, 어떤 폴더까지 보이는지, 해제 뒤 데이터가 어떻게 처리되는지 확인한다.
출력
NIST의 생성형 AI 위험 관리 자료는 그럴듯하지만 틀린 내용을 만드는 confabulation, 개인정보, 정보 무결성, 과도한 의존을 주요 위험으로 다룬다. AI 출력은 사실 확인과 개인정보 재검사를 거쳐야 한다.
재공유와 기록
결과를 주보·설교·공지에 붙이는 순간 새로운 공개가 일어난다. 누가 입력했고 누가 검토했는지 최소한의 기록을 남기되, 기록 자체에 민감정보를 복제하지 않는다.
제품 검토표
| 질문 | 확인할 문서 |
|---|---|
| 입력이 모델 학습에 쓰이는가 | 데이터 사용·모델 개선 정책 |
| 얼마 동안 보관되는가 | 보관·삭제 정책 |
| 관리자가 계정을 통제할 수 있는가 | 조직 관리·접근 제어 문서 |
| 외부 앱에 연결되는가 | 연결 앱 권한과 감사 로그 |
| 사고가 나면 무엇을 할 수 있는가 | 삭제, 지원, 사고 대응 절차 |
교회 정책은 도구 이름보다 데이터 유형을 중심으로 만든다
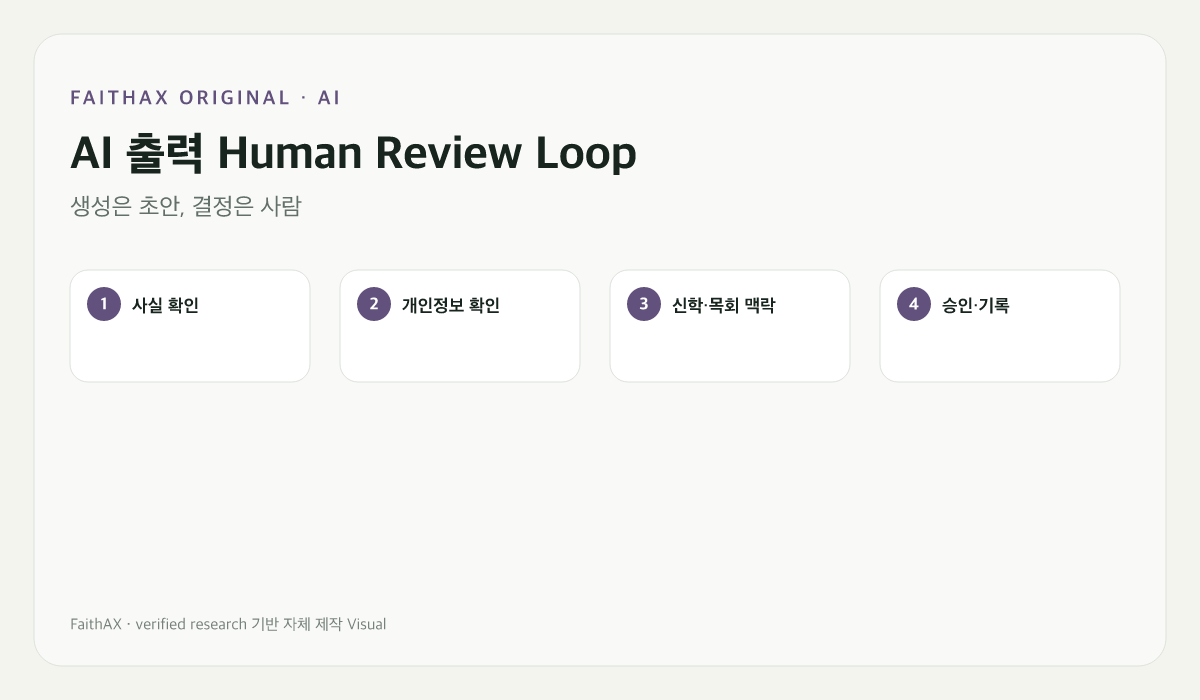
서비스 목록은 빠르게 바뀐다. 대신 “공개된 행사 문구는 허용”, “개인 식별 가능 상담·기도·아동·재정 정보는 금지”, “사람 검토 없이 외부 공개 금지”처럼 데이터와 행위를 기준으로 규칙을 세우면 새 도구에도 적용할 수 있다.
사고가 발생했을 때
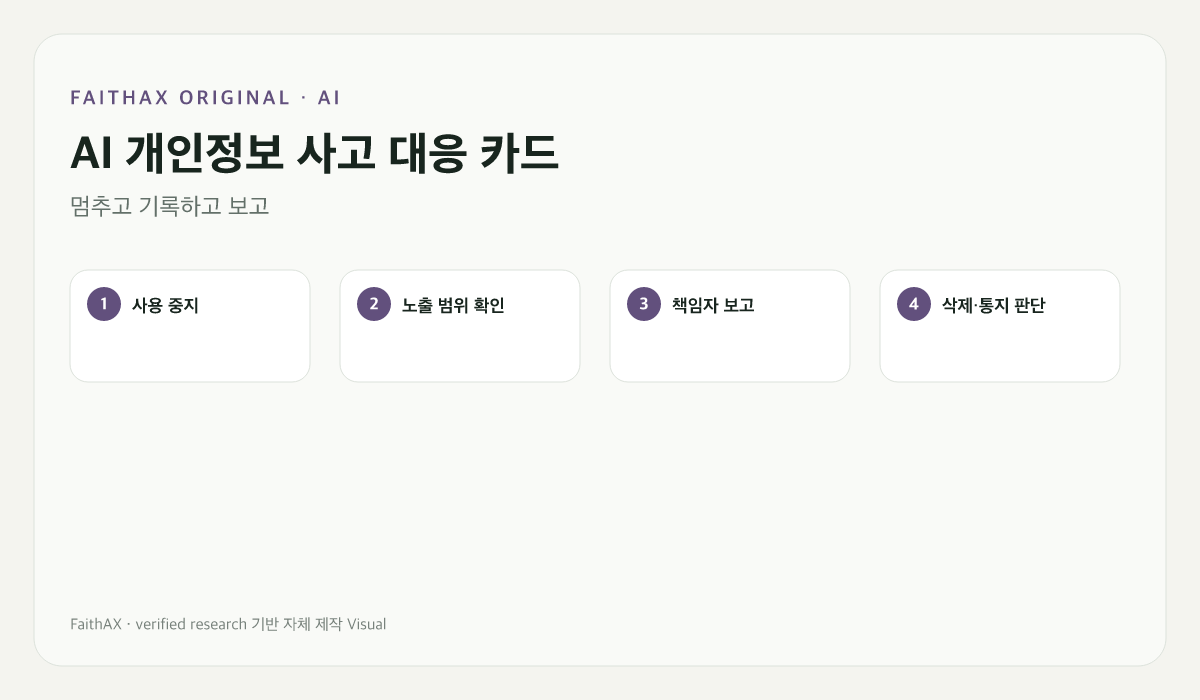
추가 입력과 공유를 중단하고, 어떤 계정·제품·자료가 관련됐는지 사실을 보존한다. 교회 책임자에게 알리고 공급자의 삭제·지원 절차와 적용되는 지역 법률을 확인한다. 삭제됐다고 추정하거나 영향을 축소하지 않는다.