AI 영상에서 손이 변형되거나, 배경 물체가 갑자기 움직이거나, camera가 의도하지 않은 방향으로 흔들리는 문제를 형용사 몇 개로 해결하기는 어렵습니다. 영상은 한 장의 image와 달리 여러 frame 사이에서 인물·사물·공간·camera의 상태가 계속 이어져야 합니다. 한 prompt에 인물 외형, 복잡한 행동, camera 이동, 조명 변화, style 전환을 동시에 요구하면 model이 어느 관계를 우선해야 하는지 불명확해집니다.
좋은 prompt는 길어서가 아니라 한 shot에서 무엇이 고정되고 무엇이 변하는지 분명해서 유용합니다. Runway, Adobe Firefly, Google Veo의 공식 안내는 표현 방식은 다르지만 subject, action, camera, scene, style과 reference를 구분한다는 공통점을 보입니다.
어색함은 세 종류의 motion이 충돌할 때 커진다
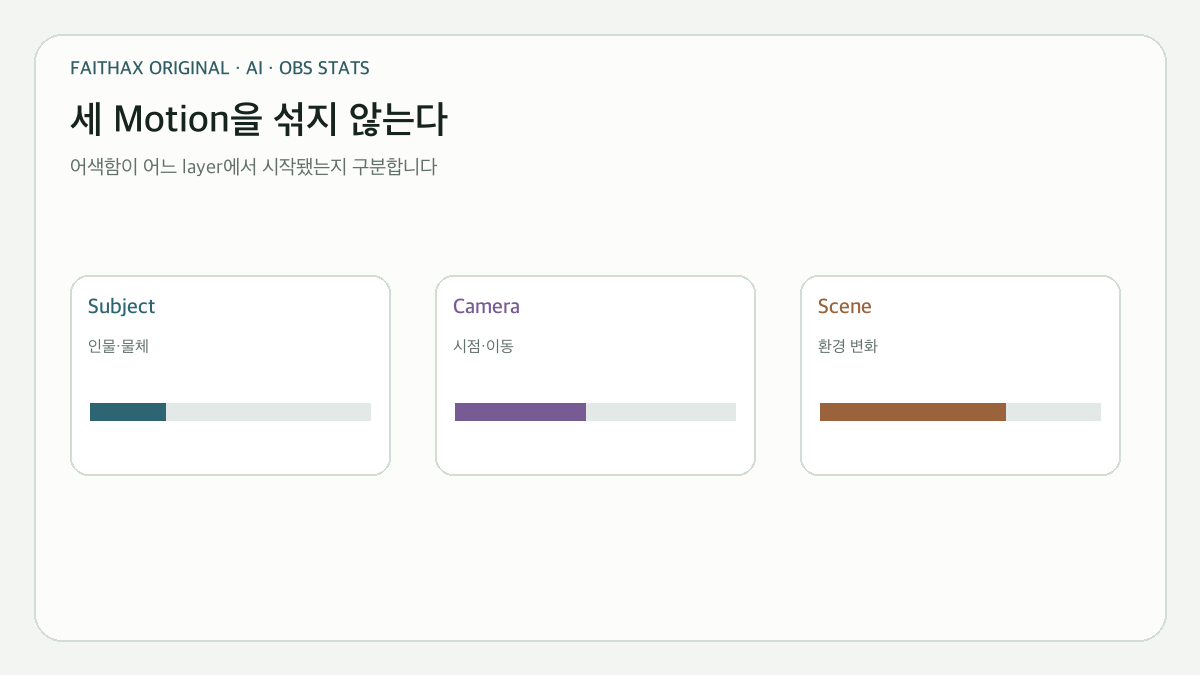
Subject motion은 인물이나 물체가 하는 행동입니다. Camera motion은 촬영 시점이 pan·tilt·dolly·zoom·handheld로 움직이는 방식입니다. Scene motion은 바람, 물, 먼지, 조명, 군중처럼 환경이 변하는 방식입니다. “역동적이고 감동적인 장면”은 이 세 가지 중 무엇이 어떻게 움직이는지 말하지 않아 model의 해석 범위를 넓힙니다.
| Motion layer | 답할 질문 | 모호한 표현 | 더 관찰 가능한 표현 |
|---|---|---|---|
| Subject | 누가 무엇을 어떻게 하는가 | 사람이 기뻐한다 | 한 사람이 고개를 들어 미소 짓는다 |
| Camera | 시점은 고정인가 이동하는가 | cinematic camera | eye-level medium shot, locked camera |
| Scene | 환경의 무엇이 변하는가 | 분위기가 살아난다 | 커튼이 약하게 움직이고 창빛은 일정하다 |
| Time | 행동은 어떤 순서·속도인가 | 천천히 변화한다 | 5초 동안 손을 내리고 시선만 오른쪽으로 옮긴다 |
Runway의 Gen‑4 guide는 image-to-video에서 입력 image가 subject·composition·color·lighting·style을 이미 제공하므로 text prompt는 motion을 중심으로 단순하게 시작하라고 안내합니다. Subject 설명을 text에서 다시 과도하게 바꾸면 첫 frame과 충돌할 수 있습니다.
한 shot에는 하나의 주된 변화만 둔다
짧은 clip에 “인물이 걷다가 책을 열고 camera가 회전하며 교회 내부가 밤에서 아침으로 변한다”를 넣으면 여러 상태 전환을 동시에 해결해야 합니다. 이를 인물 이동, 손 동작, camera 이동, 시간 변화의 네 shot으로 나누면 각 결과를 고르거나 다시 만들기 쉬워집니다.
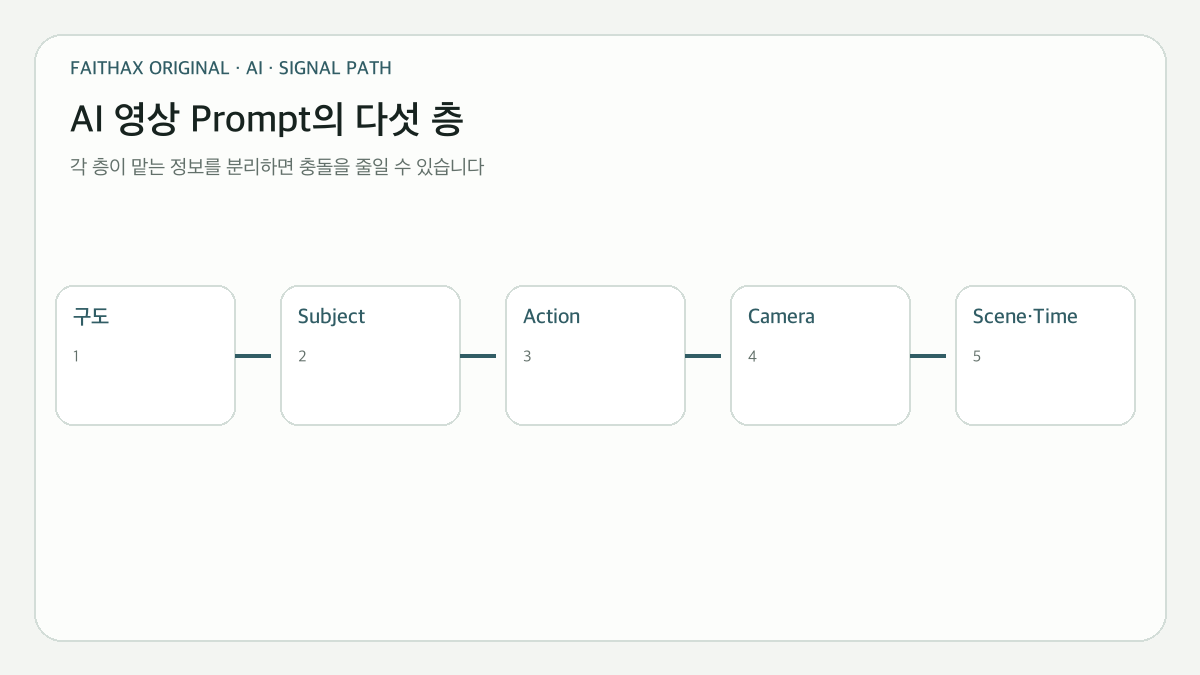
한 shot의 prompt는 framing + subject + action + environment + motion/style 정도로 구성할 수 있습니다. Adobe는 shot type, character, action, location, aesthetic이라는 구조를 제안하고 camera angle과 movement를 별도 control로 제공합니다. 이는 고정 문장 template이 아니라 필요한 요소가 빠졌는지 확인하는 문법입니다.
Positive phrasing은 “하지 마”보다 목표 상태를 묘사한다
“camera movement 없음”, “손 변형 금지”, “배경이 바뀌지 않음”처럼 금지 목록을 길게 쓰면 model에 따라 반대로 해석되거나 해당 개념을 더 강조할 수 있습니다. Runway는 Gen‑4에서 positive phrasing을 권장하며 “no camera movement”보다 “locked camera, the camera remains still”처럼 원하는 상태를 쓰도록 설명합니다.
변형을 줄이려면 “손을 이상하게 만들지 마”가 아니라 손이 frame 밖에 있도록 구도를 바꾸거나, “두 손은 책 위에 놓인 채 움직이지 않는다”처럼 보이는 상태를 정의합니다. Prompt만으로 구조적 한계가 사라지는 것은 아니므로 중요한 손글씨·로고·성경 본문은 생성 장면 안에서 맡기기보다 후속 편집 layer로 올리는 편이 안전합니다.
Reference는 외형과 구도를 고정하는 별도의 입력이다
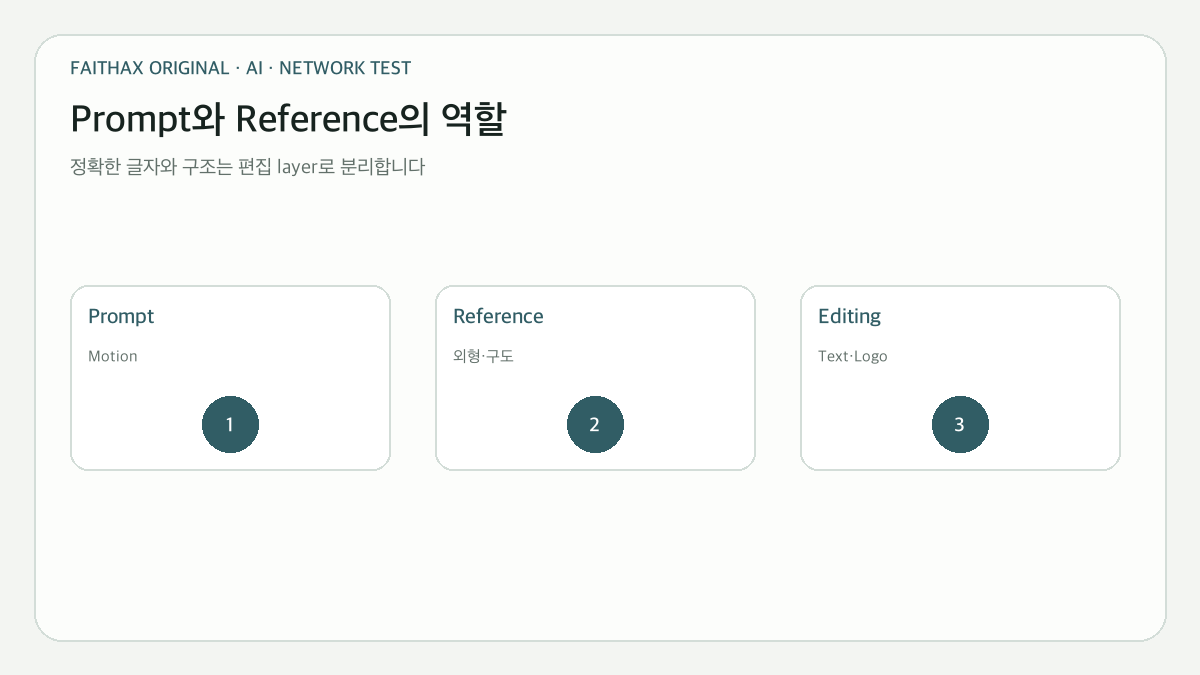
Image reference는 인물, 공간, 색, 구도의 출발점을 줍니다. First frame과 last frame을 지원하는 도구에서는 시작과 끝의 상태를 정해 중간 motion의 범위를 좁힐 수 있습니다. Motion reference는 camera의 pan·zoom·tilt·path를 sample video에서 가져옵니다. Adobe Firefly는 motion reference와 shot size·angle·motion control의 관계 및 first/last frame 사용을 공식적으로 설명합니다.
Reference가 많다고 항상 안정적인 것은 아닙니다. 서로 다른 조명, lens perspective, 인물 비율을 가진 image를 섞으면 충돌합니다. 한 shot의 목적에 필요한 최소 reference를 사용하고, 같은 인물의 정면·측면처럼 식별 관계가 분명한 자료를 고릅니다.
| 문제 | Prompt만 바꿀 때 | Reference/편집으로 해결할 때 |
|---|---|---|
| 인물이 shot마다 달라짐 | 같은 외형 설명을 반복 | 승인된 동일 reference와 seed/control 재사용 |
| logo·문자가 깨짐 | 철자를 계속 강조 | 깨끗한 후속 graphic layer로 합성 |
| camera가 흔들림 | “locked camera” 명시 | static control 또는 motion reference 사용 |
| 시작·끝 구도가 다름 | 시작과 종료 상태를 짧게 기술 | first/last frame control 활용 |
| 복잡한 손 동작 | 한 동작씩 분리 | 실제 촬영 insert나 crop으로 대체 |
Camera 언어는 위치·크기·이동을 분리한다
Close-up과 zoom-in은 같은 말이 아닙니다. Close-up은 frame 안에서 subject가 차지하는 크기이고, zoom은 lens가 시간에 따라 화각을 바꾸는 motion입니다. Dolly-in은 camera 자체가 가까워져 perspective도 달라집니다. “wide shot, eye level, locked camera”처럼 shot size, angle, movement를 나누면 상충 지시가 줄어듭니다.
Google Veo와 Adobe의 guide는 static/locked, pan, tilt, dolly, zoom, aerial, low/high angle 같은 camera vocabulary를 제공합니다. 낯선 영화 용어를 많이 넣는 것이 목적이 아니라, 실제로 필요한 한 가지 camera 행동을 정확히 고르는 것이 목적입니다.
불연속은 prompt가 아니라 편집 단위에서 해결할 때가 많다
긴 장면 하나를 완벽하게 만들려 하기보다 3–8초 shot 여러 개를 만들고 edit에서 연결합니다. Establishing shot, medium action, detail insert처럼 역할을 나누면 각 shot의 생성 부담이 줄어듭니다. 장면 사이에는 방향, screen position, lighting, costume, prop 상태를 기록한 continuity note를 둡니다.
교회 행사 홍보 영상이라면 생성 clip은 분위기와 motion을 담당하고, 행사명·일시·장소·교회 logo는 편집 프로그램에서 정확한 text로 넣습니다. AI가 만든 가상의 예배 장면을 실제 교회 행사 기록처럼 오인하게 하지 않도록 caption이나 제작 표기도 검토합니다.
반복 생성은 “좋아질 때까지”가 아니라 변수별 실험이다
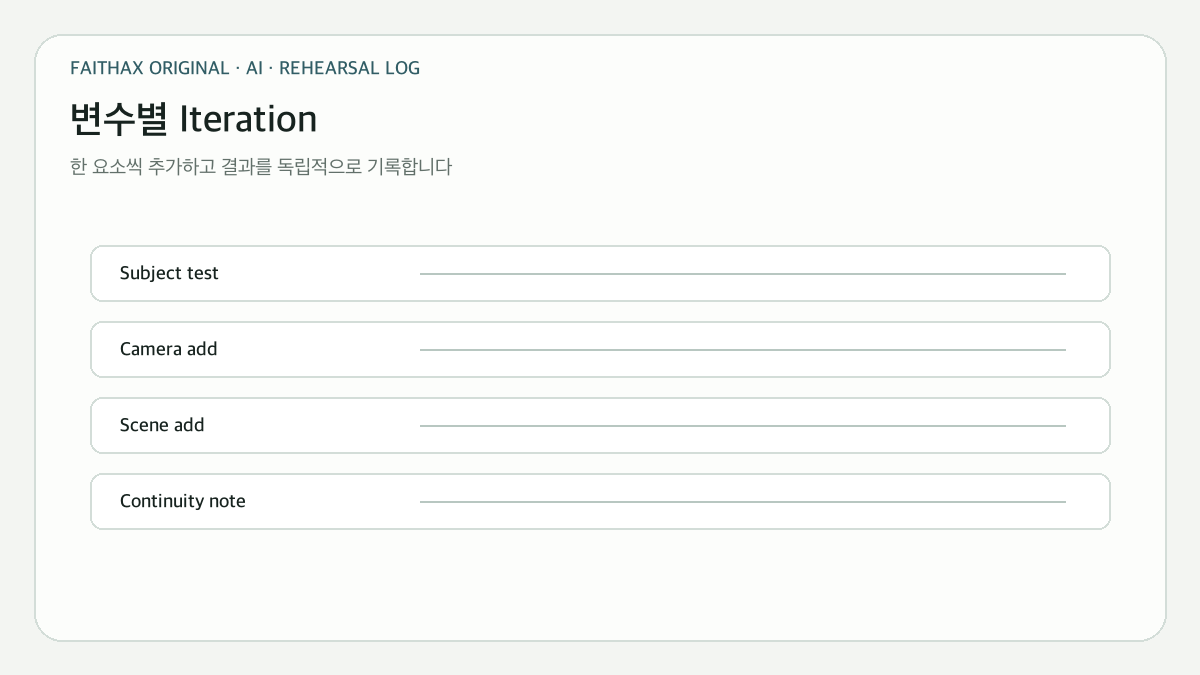
첫 generation에서 subject motion만 시험하고, 통과하면 camera motion을 추가합니다. 다음에는 scene motion이나 style descriptor 하나를 더합니다. Runway도 핵심 motion으로 단순하게 시작하고 한 요소씩 추가하는 iteration을 권장합니다. Seed와 model version, aspect ratio, duration, reference, prompt를 함께 기록해야 무엇이 결과를 바꿨는지 알 수 있습니다.
평가표에는 subject identity 유지, 손·얼굴 구조, 배경 continuity, camera 지시 준수, 불필요한 motion, 공개 가능한 content 여부를 별도로 기록합니다. “더 cinematic”처럼 하나의 감상 점수로 합치면 다음 수정이 모호해집니다.
교회 콘텐츠에서 지켜야 할 입력·권리 경계
교인 얼굴, 아동, 상담 내용, 비공개 행사 사진을 reference로 올리기 전에 동의·보관·학습·삭제 정책을 확인합니다. NIST AI RMF의 Map·Measure·Manage 관점은 사용 목적과 영향을 정의하고, 실제 실패를 측정한 뒤 대응을 운영하게 합니다. U.S. Copyright Office의 AI 자료처럼 저작권 쟁점도 계속 검토 중이므로 서비스가 상업 이용을 허용한다는 문장만으로 입력 사진·logo·음악·인물 권리가 해결됐다고 보지 않습니다.
결론: Prompt는 한 shot의 변화 계약서다
어색한 영상을 줄이는 핵심은 수식어를 늘리는 일이 아닙니다. 첫 frame에서 고정할 정보와 시간에 따라 변할 subject·camera·scene motion을 나누고, 한 shot에 하나의 주된 변화를 둡니다. 외형과 구도는 reference, 정확한 글자와 logo는 편집, 긴 이야기는 여러 shot의 continuity로 해결합니다. 이 구조가 있어야 실패한 결과도 어느 layer에서 어긋났는지 설명하고 다시 만들 수 있습니다.
공식 자료
- Runway Gen‑4 Video Prompting Guide — Runway
- Adobe video prompt guide — Adobe
- Adobe Generate video controls — Adobe
- Adobe motion reference — Adobe
- Google Veo prompt guide — Google Cloud
- NIST AI Risk Management Framework — NIST
- Copyright and Artificial Intelligence — U.S. Copyright Office